导演板
强调叙事节奏与剪辑点,画质可粗糙。目标是对齐团队意图与 Spec。
OUT → 审批闸门 / 时长轴
本 Wiki 以工作流编排为脊柱,把剧本、NLU、分镜、镜头、提示词工程、静帧/视频生成、ControlNet、音频与资产管理串成一条可执行的生产线——不是概念堆砌,而是「下一站接什么、产出什么、用什么模型、怎么写 prompt」。
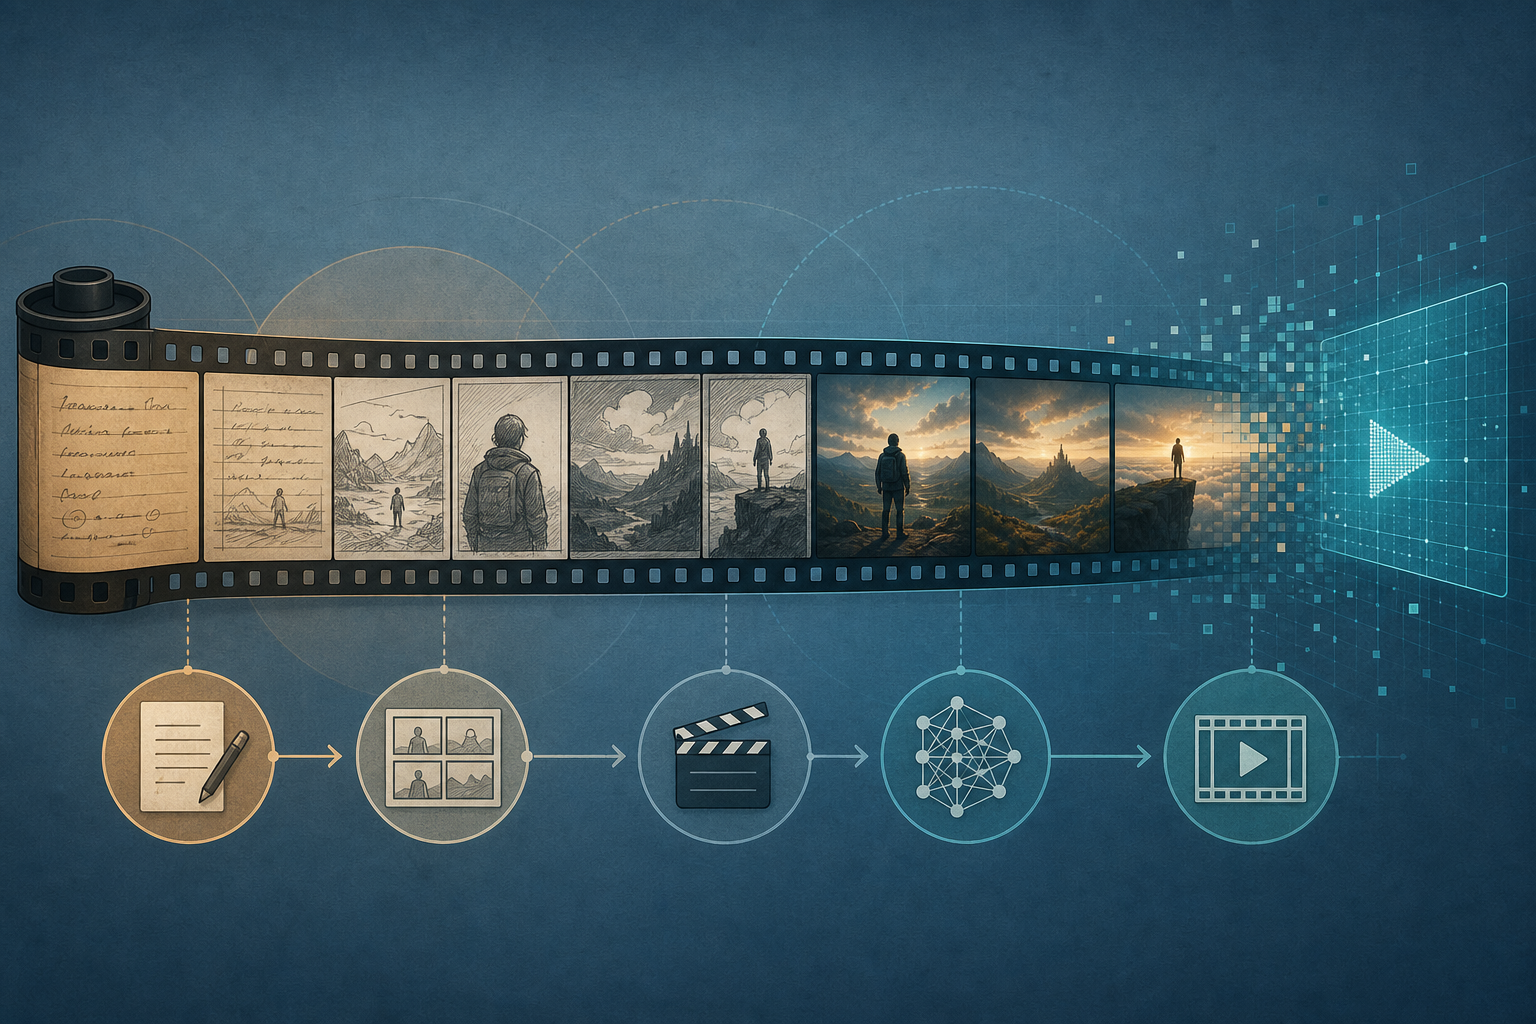
「用 AI 做视频」常被简化成一次 T2V 调用。工业级做法是分层:叙事层决定讲什么,理解层决定机器读什么,规划层决定怎么拍,生成层决定怎么画/怎么动,媒体层决定声音与成片规格,资产层保证跨镜头一致。
六层架构:资产层横向贯穿,其余层纵向推进
工作流编排(Workflow Orchestration)是把离散能力变成有向无环图(DAG)或状态机:每个节点声明输入契约、模型/工具、输出制品与失败重试策略。下面的交互图把本 Wiki 全部概念挂在同一条管线上——这是全书的索引与脊梁。
| 能力 | 说明 | 与本 Wiki 概念的关系 |
|---|---|---|
| 依赖调度 | 按 DAG 拓扑执行;上游制品就绪才触发下游 | 分镜依赖 NLU Spec;首尾帧依赖审核通过的静帧;T2V/FLF 依赖双帧与 Control |
| 契约校验 | JSON Schema / 媒体探针校验分辨率、时长、声道 | Shot Spec、Asset ID、条件图尺寸对齐 |
| 分支与人审 | 关键帧、定妆、试听可插入人工审批闸门(HITL) | 资产一致性、镜头语言、品牌安全 |
| 缓存与复用 | 相同 prompt+seed+资产哈希命中则跳过重算 | 资产管理中的版本与溯源 |
| 失败策略 | 超时重试、降级模型、局部重跑单镜头 | T2V 失败可回退 I2V;Control 权重可调;长片见 问题与对策 |
不要把「整部片子」当成一个黑盒 API。以镜头(Shot)为最小可调度单元,用资产 ID 与 Spec 做跨镜粘合,工作流才可并行、可回滚、可审计。
面向生成的剧本更接近「可编译源码」:场次清晰、实体可链接、动作可视觉化、对白可时长化。散文式描写会增加 NLU 歧义,拖垮下游一致性。
| 字段 | 含义 | 下游用途 |
|---|---|---|
scene_id | 场次编号 | 资产场景绑定、并行调度键 |
slugline | 内外景 / 地点 / 日夜 | 场景板、光位提示 |
action | 可见动作与空间关系 | 分镜、Pose/Depth 条件 |
dialogue | 角色对白 | TTS、唇形、字幕 |
emotion | 情绪与节奏 | 运镜强度、配乐、表演 |
duration_hint | 建议时长 | T2V 秒数、剪辑点 |
asset_refs | 角色/道具 ID | IP-Adapter / LoRA 注入 |
角色 char.lin 坐在窗边,侧光。她把一封信推过桌面给 char.zhao。
LIN:「你还记得雨夜的码头吗?」
情绪:压抑 → 试探。建议时长 6s。镜头:中景推至特写。
这段同时喂给:NLU(实体与景别)、资产(两个角色 ID)、音频(对白)、镜头(推轨)、生成(侧光窗边茶馆)。
NLU(Natural Language Understanding)在此不只是聊天:它把剧本编译成 Shot Spec——下游节点的统一接口。常见子任务包括意图识别、槽位填充、指代消解、实体链接到资产库、以及镜头语法映射。
剧本 → NLU 编译 → Spec + 资产链接 → 多下游消费
{ "shot_id": "S12-02", "scene_id": "12", "cast": ["char.lin", "char.zhao"], "framing": "MCU → CU", "camera_move": "dolly_in", "lighting": "side_window_night", "action": "pass_letter_across_table", "dialogue": [{ "who": "char.lin", "text": "你还记得雨夜的码头吗?" }], "control_hints": ["openpose", "depth"], "duration_sec": 6, "start_frame": "assets/S12-02_start.png", "end_frame": "assets/S12-02_end.png", "style_ref": "style.noir_teal" }
有了 Spec,工作流可以把「同一镜头」路由到 T2I(关键帧)、ControlNet(姿态)、I2V/T2V(运动)和 TTS(对白),而不是每段重新解读自然语言。
分镜(Storyboard)是视觉规划层:把 Shot Spec 落实为关键帧、时长与转场。AI 流水线中,分镜可以是手绘扫描、T2I 批量生成,或「草图 ControlNet + 资产参考」的混合产物。
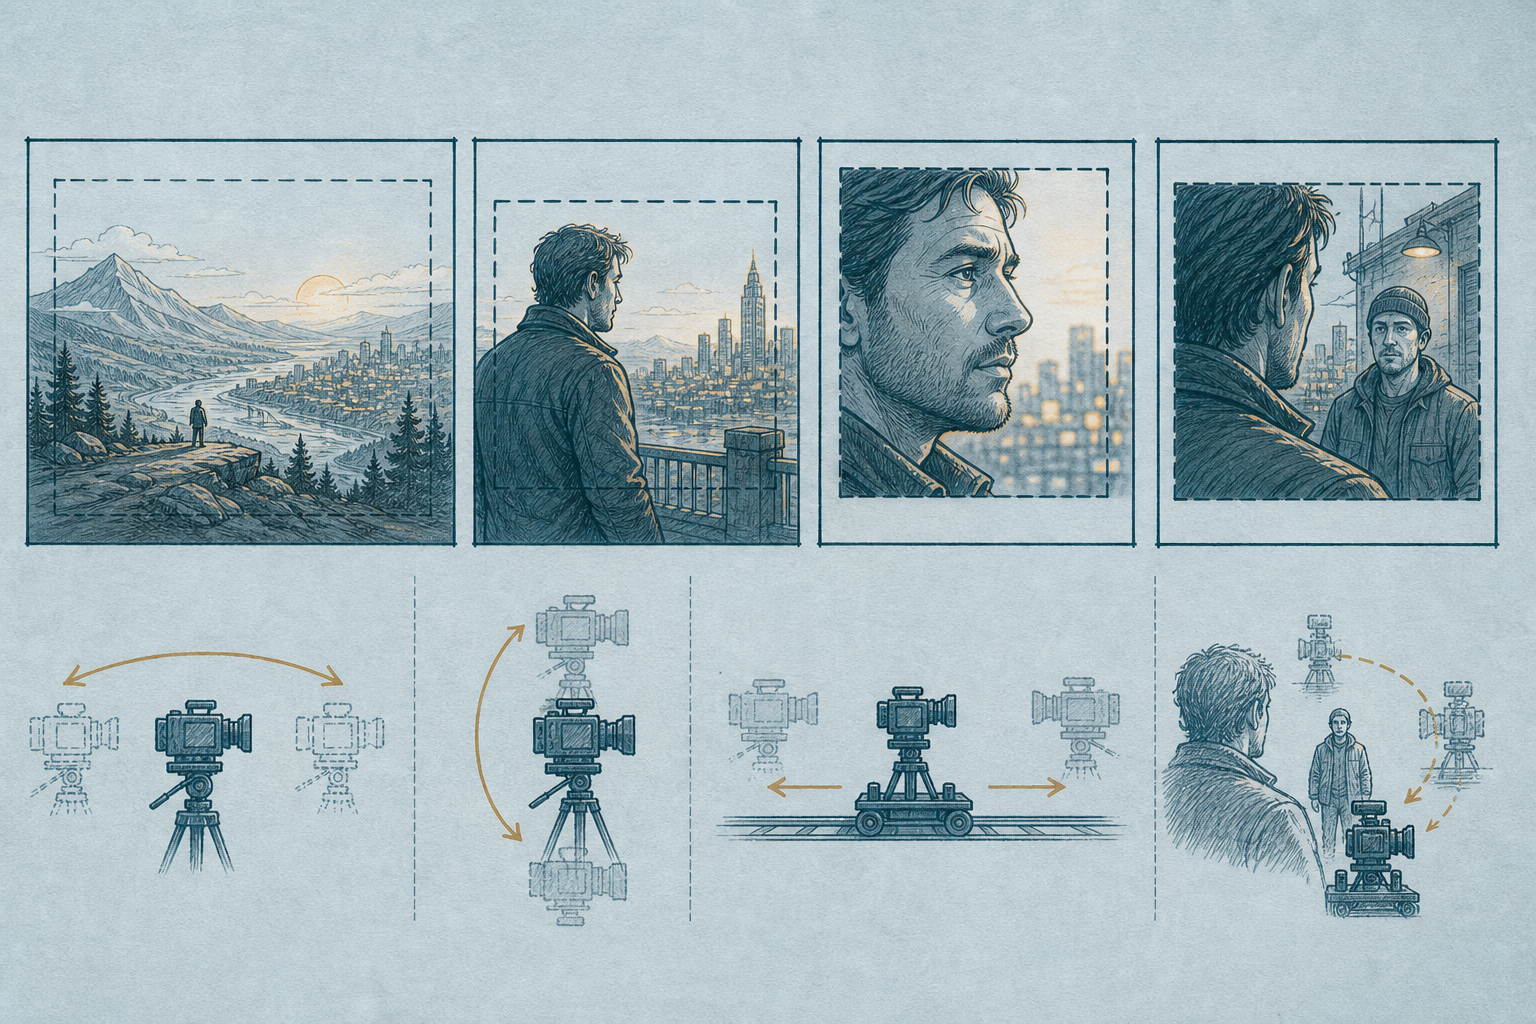
强调叙事节奏与剪辑点,画质可粗糙。目标是对齐团队意图与 Spec。
用 T2I + 资产参考产出高质量定妆与场景板。运镜落幅明确时,同时产出首帧与尾帧供插值。
从分镜提取线稿、深度、姿态,喂给 ControlNet,锁定构图。
镜头语言把「怎么拍」编码成可注入 prompt、相机轨迹与条件图的参数。景别决定信息量,运镜决定情绪张力,剪辑决定信息释放节奏。
建立环境与空间关系,开场常用。
人物全身与场景互动,交代走位。
膝上或腰上,对白场景主力。
胸口以上,情绪与表情过渡。
脸部或关键道具,强化心理。
眼睛、手指、细节物件。
对话空间关系,双人戏经典。
角色视点,代入感与悬念。
| 运镜 | 叙事效果 | 生成侧常见做法 |
|---|---|---|
| 推 / Dolly In | 压迫、聚焦 | 首尾帧 + I2V;或相机轨迹条件 |
| 拉 / Dolly Out | 揭示、疏离 | 宽构图尾帧引导;避免主体崩坏 |
| 摇 / Pan | 扫视空间 | 横向运动强度;注意拖影与身份漂 |
| 移 / Truck | 跟随、伴行 | Pose 序列 + 视频 Control |
| 升 / 降 | 权力关系、史诗感 | 多关键帧插值;深度图保持地平线 |
| 手持 | 纪实、不安 | 提高运动噪声;后期加微抖需谨慎 |
静帧与视频生成不是互相替代,而是流水线上的不同工序。先建立可控静帧,再进入运动,通常比「一步出片」更稳。
文本到图像。用于概念板、角色定妆、场景板与高质量关键帧。
在参考图结构上重绘:换风格、细化、局部重绘(inpaint)、换装。
文本到视频。适合强创意、弱身份约束的镜头;长镜头一致性仍是难点。
关键帧延展为视频,是分镜落地最常用路径,身份保持通常优于纯 T2V。
同时给定起幅与落幅,模型在两帧间插值运动。落幅构图已知时优于单图 I2V。
保留源视频运动/结构,替换风格或角色。适合风格化二创与统一调性。
用条件图约束生成,连接「镜头意图」与「像素结果」。
T2I负责「从零建立视觉」。提示词通常包含主体、场景、光影、镜头焦距、风格参考。结合 IP-Adapter / 角色 LoRA 可把资产库中的脸与服装锁进画面。
I2I负责「在已有结构上迭代」。denoising strength 低则保构图,高则更自由。局部 inpaint 用于改道具、修手、换背景而不破坏全身一致性。
分镜关键帧节点几乎总是 T2I/I2I。输出写入镜头制品库,供 Control 预处理与 I2V 读取。Seed、模型哈希、资产版本应一并入库以便复现。
ControlNet(及同类适配器)在扩散主模型旁路注入条件特征。条件来自分镜或几何预处理器,而不是只靠文字碰运气。
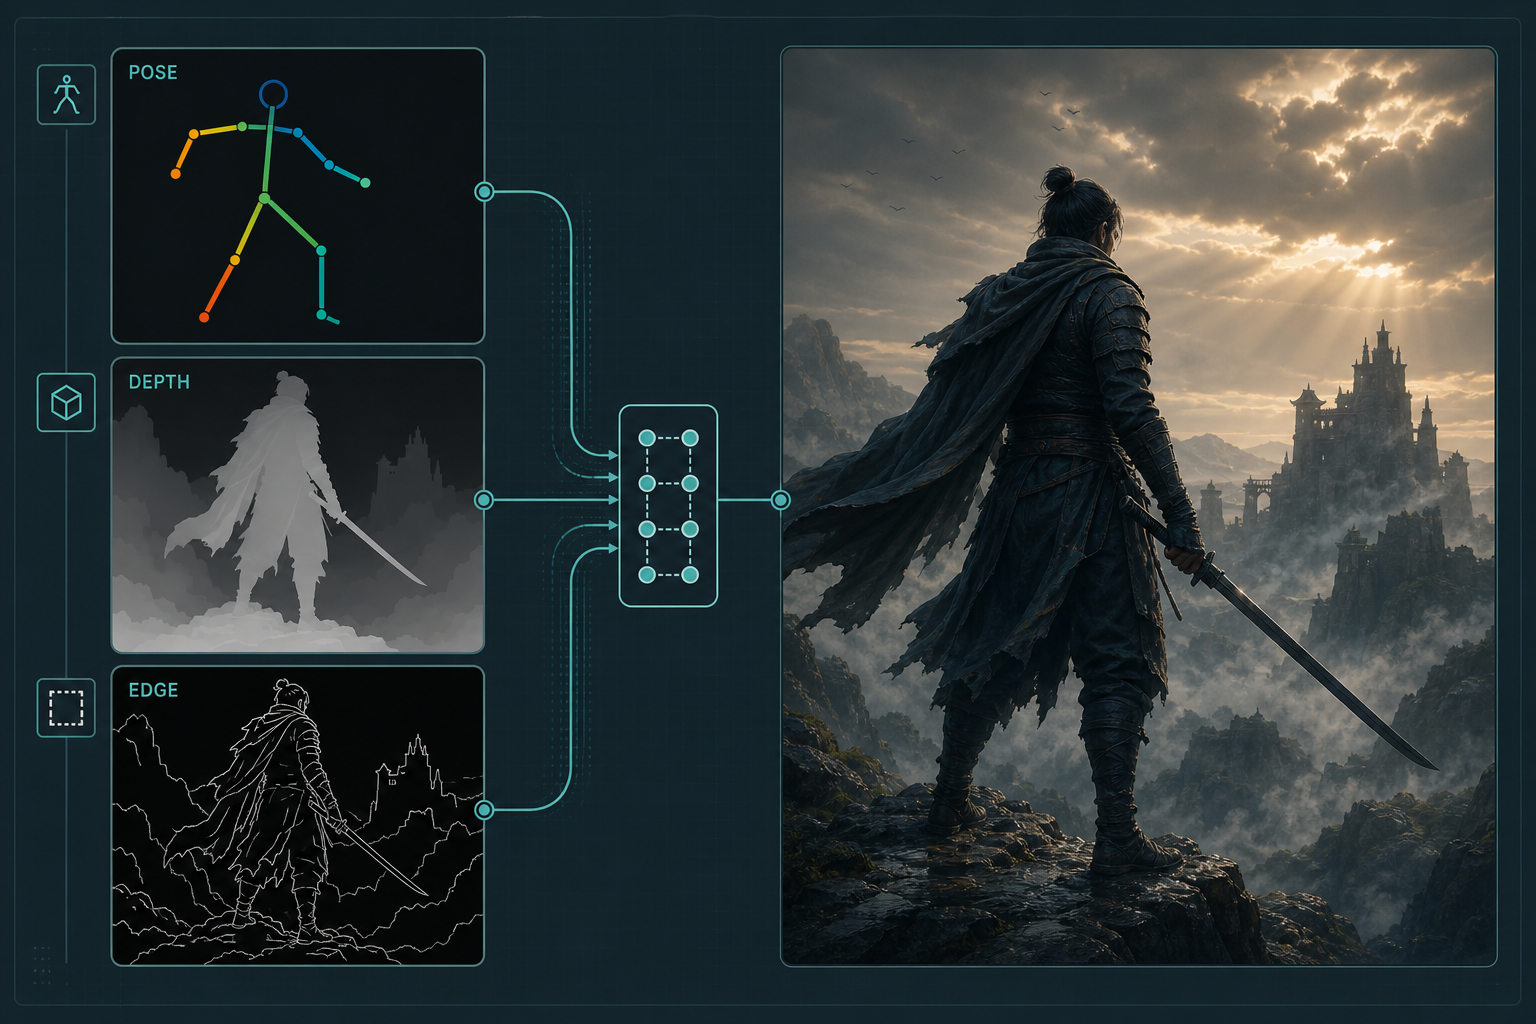
| 条件类型 | 提取方式 | 典型用途 |
|---|---|---|
| Canny / Lineart | 边缘检测 | 锁定构图与轮廓 |
| Depth | 单目深度估计 | 空间层次、推拉时的透视 |
| OpenPose | 人体关键点 | 表演姿势、多人站位 |
| SoftEdge / Scribble | 软边/涂鸦 | 粗分镜快速约束 |
| Tile / Reference | 分块/参考 | 高清放大、风格贴合 |
| 视频 Pose/Depth 序列 | 逐帧或稀疏关键帧 | V2V / 可控视频 |
权重过高会「画不动」;过低则失控。工作流里常把 Control 权重做成可调参数,并与镜头运动强度联动。
T2V:文本直接出视频,迭代快,但角色身份、品牌道具、长时一致性较弱,适合氛围镜头或早期探索。
I2V:从审核过的关键帧延展,是工业化默认路径——先用 T2I+Control 把「长什么样」定死,再让模型「怎么动」。
V2V:输入已有视频(实拍或生成),在运动结构上重绘。适合统一全片风格、角色替换、季节/时段变换。常配合光流、深度或 Control 序列减少闪烁。
当镜头的落幅构图已知时,升级为 首尾帧(Start–End Frame):同时约束起幅与落幅,比单图 I2V 更可控。
短镜优先 I2V;落幅明确用首尾帧;跨镜锁资产 Embedding/LoRA;运动剧烈时降幅度或加 Pose 序列;闪烁用时序约束或后处理稳定。
首帧(Start / First Frame)是镜头开始时的画面;尾帧(End / Last Frame)是镜头结束时应到达的画面。 首尾帧生成(也称 Start–End I2V、关键帧插值、FLF)让视频模型在两张静帧之间「补运动」,而不是只从一张图自由延展。它是分镜里「这一镜从哪开始、到哪结束」在生成侧的直接落地。
首帧 → 受约束插值 → 尾帧;比单图 I2V 多一个落幅锚点
| 模式 | 输入 | 模型自由度 | 最适合 |
|---|---|---|---|
| 纯 T2V | 文本 | 最高 | 探索氛围、弱身份空镜 |
| 单图 I2V | 首帧 + 文本 | 中高(落幅不可控) | 微动、风吹、轻微表情 |
| 首尾帧 | 首帧 + 尾帧 ± 文本 | 中(起落双锚) | 推拉摇移、姿态变化、明确落幅构图 |
| 多关键帧 / 轨迹 | 3+ 帧或相机路径 | 更低 | 复杂走位、长镜头分段 |
推近到特写、拉出揭示环境、摇镜扫过桌面——首帧定起幅,尾帧定落幅构图。
举手、递信、转身:两帧 Pose 差可控时效果最好;差过大易肢体撕裂。
上一镜尾帧经裁切/I2I 后作为下一镜首帧,维持角色与空间连续性。
正面静置 → 微旋转/开盖后的落幅,材质与 Logo 区域需两帧一致。
| 要点 | 做法 | 为何重要 |
|---|---|---|
| 身份一致 | 同一资产 / IP-Adapter / 从首帧 I2I 出尾帧 | 避免中段换脸、服装跳变 |
| 几何可插值 | 姿态、机位变化「一步能走完」;过大则拆成两段 | 降低肢体扭曲与鬼影 |
| 画幅对齐 | 分辨率、宽高比、主体比例一致 | 模型不会自动「合理裁切」时易拉伸 |
| 光影连续 | 光源方向与色温接近;大变光拆镜头 | 减少闪烁与材质跳变 |
| 提示词写过渡 | 写相机/主体如何从首到尾,少重复外貌 | 外貌已由双帧承担 |
| 时长匹配 | 运动幅度 ÷ 合理速度 ≈ 秒数 | 过短会抖、过长会「磨蹭变形」 |
① 分镜标出起幅/落幅 → ② T2I(+Control)出首帧并人审 → ③ 以首帧为底 I2I/Control 改构图出尾帧(或独立 T2I 但锁同一资产)→ ④ 首尾帧 + motion prompt 送入支持 FLF 的视频模型 → ⑤ 不合格则减小姿态差、缩短时长或拆成两段首尾帧。 工作流节点见编排台 T2I → 首尾帧 → T2V/I2V。
首尾帧主体完全不同却要求「丝滑变身」;尾帧与首帧景别/焦距差过大却只给 2 秒; 用两张无关参考图硬套;在提示词里再写一套与尾帧矛盾的落幅描述。
首帧
MCU:char.lin 窗边侧坐,侧光,看向画外右方(已审核定妆图)
尾帧
CU:同一人物更大脸部占比,目光仍偏右,肩线略抬,光位不变(由首帧 I2I + 轻微构图上移得出)
Motion Prompt
slow dolly in from the first frame to the last frame, subtle blink, minimal head motion, keep identity, wardrobe and lighting consistent, 5 seconds, smooth continuous move
双帧已钉死起落幅;文字只负责「怎么走过去」。
问题组合
首帧:全景码头夜景(无人)
尾帧:室内特写人脸
提示词:快速切换场景,电影感爆炸
空间与主体不连续,模型只能硬切或鬼畜变形——应拆成两镜,而不是一个首尾帧任务。
提示词不是「形容词堆砌」,而是把 Shot Spec、镜头参数 与 资产别名 编译成目标模型能执行的自然语言/标签句。同一镜头对 T2I、I2V、TTS 应产出不同句式:静帧写「长什么样」,视频写「怎么动」,音频写「怎么说/怎么响」。
优质提示词按固定槽位填写,缺槽就补,多槽就拆——避免一段话里同时塞太多互相打架的主体。
① 资产用 prompt_alias(如 char.lin, short black bob, grey trench)而非「一个女人」;
② 镜头术语写成模型熟悉的摄影英文/中文(MCU、35mm、dolly in);
③ 运动只留给视频模型,静帧少写「缓慢移动」;
④ 负向提示词专治已知失败模式(多指、水印、脸崩),不要复述正向内容。
| 场景类型 | 提示词重心 | 优先模型路径 | 常见翻车 |
|---|---|---|---|
| 角色定妆 / 关键帧 | 外貌锁定 · 服装 · 光位 · 中性表情 | T2I + IP-Adapter/LoRA | 脸漂、服装乱变 |
| 三视图 / 脸部特写 | turnaround · 同装同脸 · Face ID | 资产生成 | 视角五官不一致 |
| 建立镜头 / 空镜 | 空间层次 · 天气 · 广角透视 | T2I 或强 T2V | 地平线歪、重复建筑 |
| 对白中近景 | 表情微变 · 口型预留 · 浅景深 | 关键帧 I2V + 唇形 | 说话时脸变形 |
| 推拉 / 落幅已知 | 过渡动词 · 时长 · keep identity | 首尾帧 FLF | 姿态差过大、换脸 |
| 动作 / 追逐 | 运动动词 · 速度 · 相机跟随 | I2V / T2V + Pose | 肢体撕裂、闪烁 |
| 产品 / 广告 | 材质 · 反射 · 干净背景 | T2I → I2V 微动 | Logo 糊、假字 |
| 风格化二创 | 风格锚点 · 保留构图 | V2V + Control | 身份丢、闪帧 |
| 配乐 / 环境声 | 情绪 · BPM · 乐器 · 时长 | 文生乐 / SFX | 喧宾夺主盖过人声 |
T2I/I2I 提示词应像摄影简报:主体清晰、空间可解、光可复现。I2I 时文字写「改什么」,结构交给原图与 denoise。
Prompt
一个漂亮的女孩,电影感,高质量,8k
问题:主体不可复现、无资产锚点、无镜头/光影,「电影感/8k」几乎无效噪声。
Positive
char.lin, East Asian woman, short black bob hair, grey trench coat, sitting by wooden window in traditional teahouse at night, side window light, cool teal rim light, medium close-up, 50mm lens, shallow depth of field, cinematic still, neutral expression, looking slightly off-camera, film grain subtle
Negative
deformed hands, extra fingers, watermark, logo, text, oversmoothed skin, crossed eyes, duplicate face, lowres, cartoon
主体用资产别名;光与镜头可复现;负向只打已知失败点。
Positive
wide establishing shot of rainy night harbor pier, wet asphalt reflections, distant cargo ships, sodium street lamps, volumetric mist, empty frame no people, 24mm wide angle, deep focus, anamorphic feel, muted teal and amber palette, photoreal cinematic
Negative
crowded, readable text on signs, distorted perspective, oversaturated neon, watermark
Inpaint Prompt(蒙版仅信件)
aged sealed envelope with wax stamp on wooden table, soft side light, keep original table texture and framing unchanged
I2I 少写全局风格,多写「替换物属性」;蒙版外交给原像素。
Positive
matte black wireless earbuds case centered on brushed aluminum desk, softbox key light from upper left, gentle reflection, clean minimal background gradient grey, product photography, 85mm, f/8, ultra sharp edges, no text no logo distortion
Negative
blurry logo, misspelled text, extra objects, hands, busy background, plastic sheen overdone
I2V:提示词重点写运动与镜头变化,外貌已由关键帧锁定,重复外貌描述收益低。 T2V:需同时写主体+运动,但句子宜短、因果清晰,一次只推一种主运动。 V2V:写「保留什么 / 改成什么」,并配合 Control 权重。
Prompt
她很伤感地说了一句话,然后镜头很电影地推进,氛围拉满
问题:无可执行动作、无运镜参数、情绪词无法落到像素。
Motion Prompt
slow dolly in from medium close-up to close-up on her face, subtle blink, slight lip movement as if speaking softly, shoulders still, shallow depth of field, natural micro motion, 6 seconds, keep identity and wardrobe unchanged
运镜 + 微表情 + 时长 + 身份保持指令;对白内容交给 TTS,不必写入画面 prompt。
Positive
handheld tracking shot following a young man in grey trench coat running through rain-soaked alley at night, puddle splashes, camera trucks left keeping subject centered, urgent pace, realistic motion blur on background only, continuous single take 5 seconds
Negative / 约束
teleporting limbs, sudden cut, morphing face, frozen pose, text overlay
Prompt
restyle the footage as 1980s anamorphic crime thriller, teal-orange grade, keep original camera moves, blocking and face identity, increase film grain slightly
「keep …」比「beautiful cinematic」更有效;运动结构由源视频承担。
Motion Prompt(配合首帧+尾帧图)
interpolate smoothly from start frame to end frame, slow dolly in, subtle natural motion, keep face identity and coat details, no cut, 5 seconds
详见 首尾帧专节:外貌由双帧锁定,此处只写过渡。
是否只有一个主运动?是否写了相机如何动?是否声明时长?I2V 是否写了 keep identity?首尾帧是否几何可插值?是否避免要求模型「读出屏幕上的字」?
成片前应先沉淀可复用资产:人物三视图、脸部特写、服装、道具、场景板、风格板。
这些图进入 资产库 后,下游镜头用 prompt_alias + IP-Adapter/LoRA 引用,而不是每镜重写外貌。
① 中性光、干净背景,少叙事动作;② 固定 asset_id 别名句(如 char.lin…);
③ 三视图要求「同一人物同一服装」;④ 脸部特写锁五官比例,供 Face ID;
⑤ 场景/道具写材质与尺度,避免可读文字。
正面 / 侧面 / 背面(或 3/4 侧)同比例站立,用于全身一致性、换装与 Pose 参考。一张拼图或三张分图均可入库。
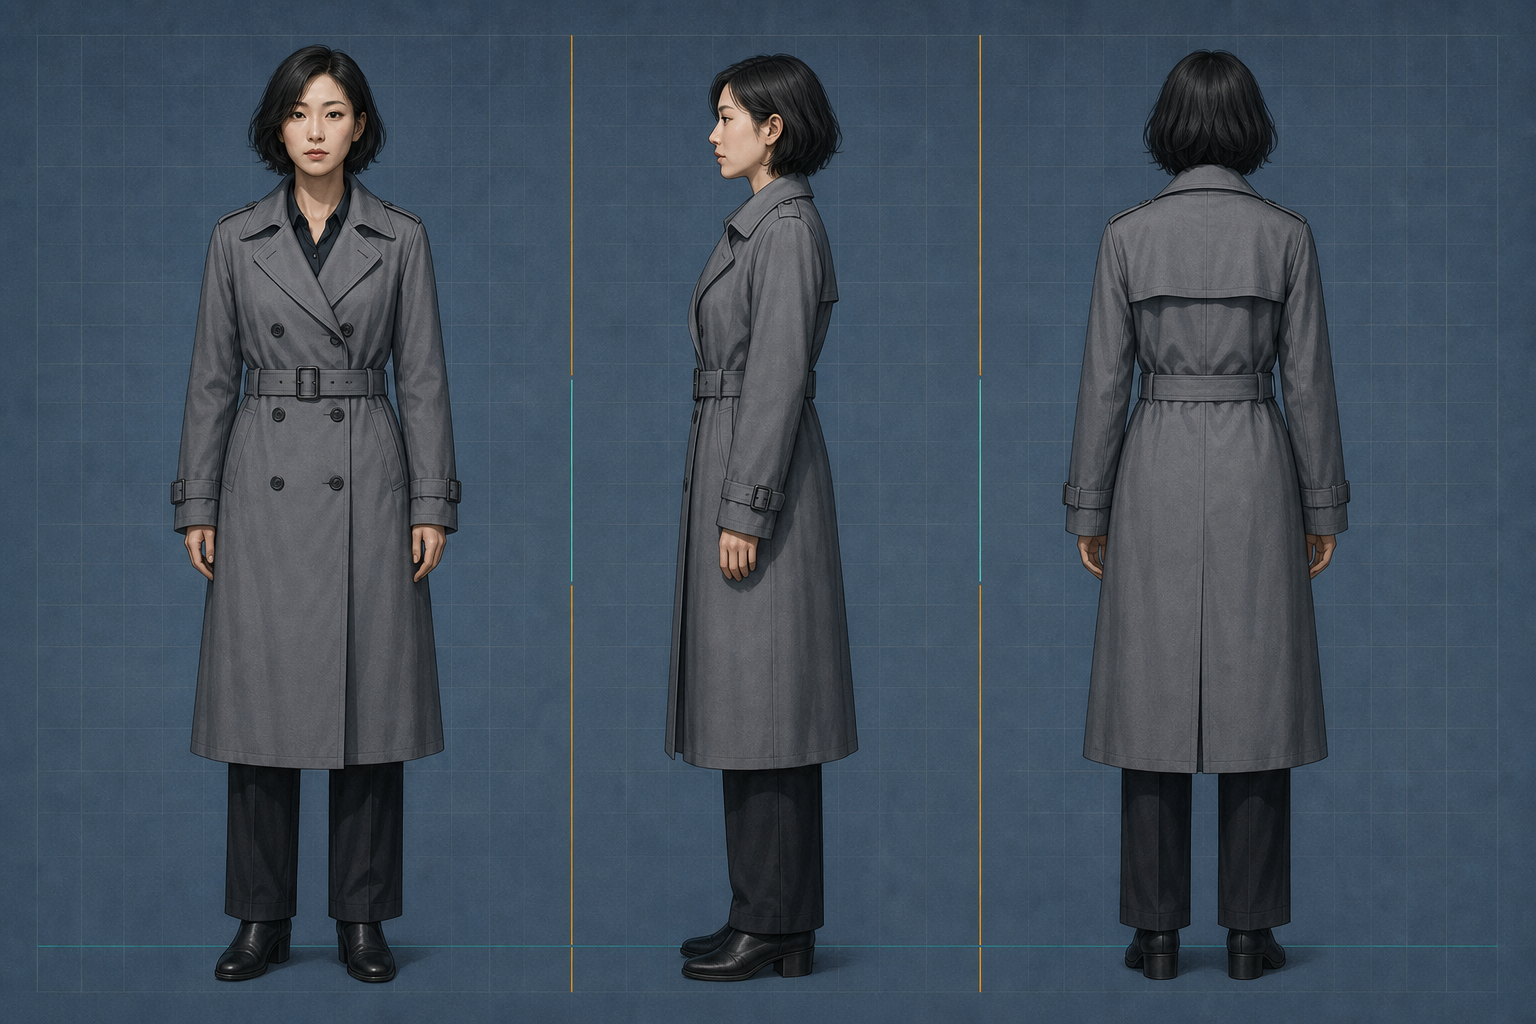
Positive
character turnaround sheet of char.lin, same East Asian woman, short black bob hair, grey trench coat, black boots, full body, three orthographic views side by side: front view, left side profile, back view, identical outfit and proportions, standing A-pose, even soft studio lighting, plain cool grey background, clean model sheet, no text, no labels, consistent face
Negative
different faces across views, crowded background, dramatic cinematic lighting, action pose, crop at knees, extra limbs, watermark, text captions
也可分三次生成(front / side / back),共用同一 seed 范围与资产参考,再人工拼板。
Prompt
美女三视图,好看,全身,电影光
缺资产别名、缺「同一服装/同一五官」、电影光会造成各视角阴影不一致,难以训 LoRA / 做 ID。
正面或微侧、表情中性、五官清晰,专供人脸一致性(IP-Adapter Face / PuLID / InstantID 等)。避免夸张表情、遮挡与强逆光。
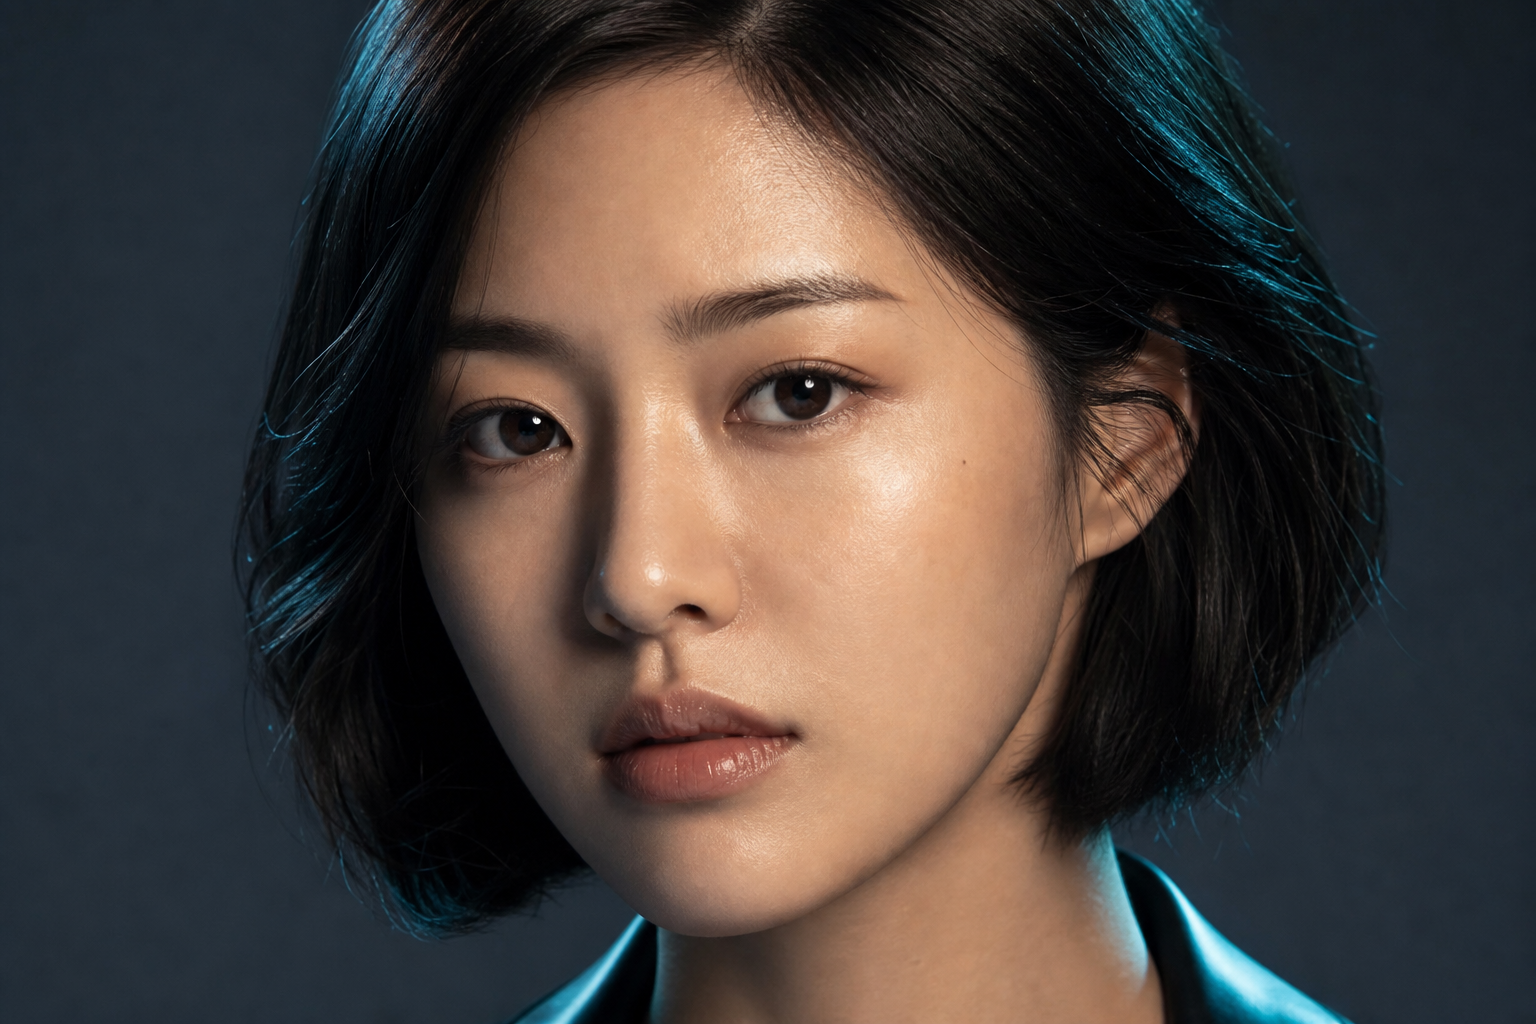
Positive
face close-up of char.lin, East Asian woman, short black bob hair framing face, neutral calm expression, eyes looking at camera, clear iris detail, natural skin texture with subtle pores, soft beauty lighting, key light from camera-left, clean cool grey backdrop, head and shoulders, 85mm portrait lens, sharp focus on eyes, no makeup heavy, identity reference photo
Negative
smile grin, crying, looking away, hair covering eyes, heavy makeup, beauty filter plastic skin, sunglasses, hands in frame, busy background, text, watermark, lowres
同一角色建议再备:微侧 3/4、微笑轻版、夜戏侧光版——入库为 char.lin.face.v1 等多变体。
场景板、服装、道具、风格板与角色资产并列,构成可检索的美术包。下图为四类资产拼版示意。
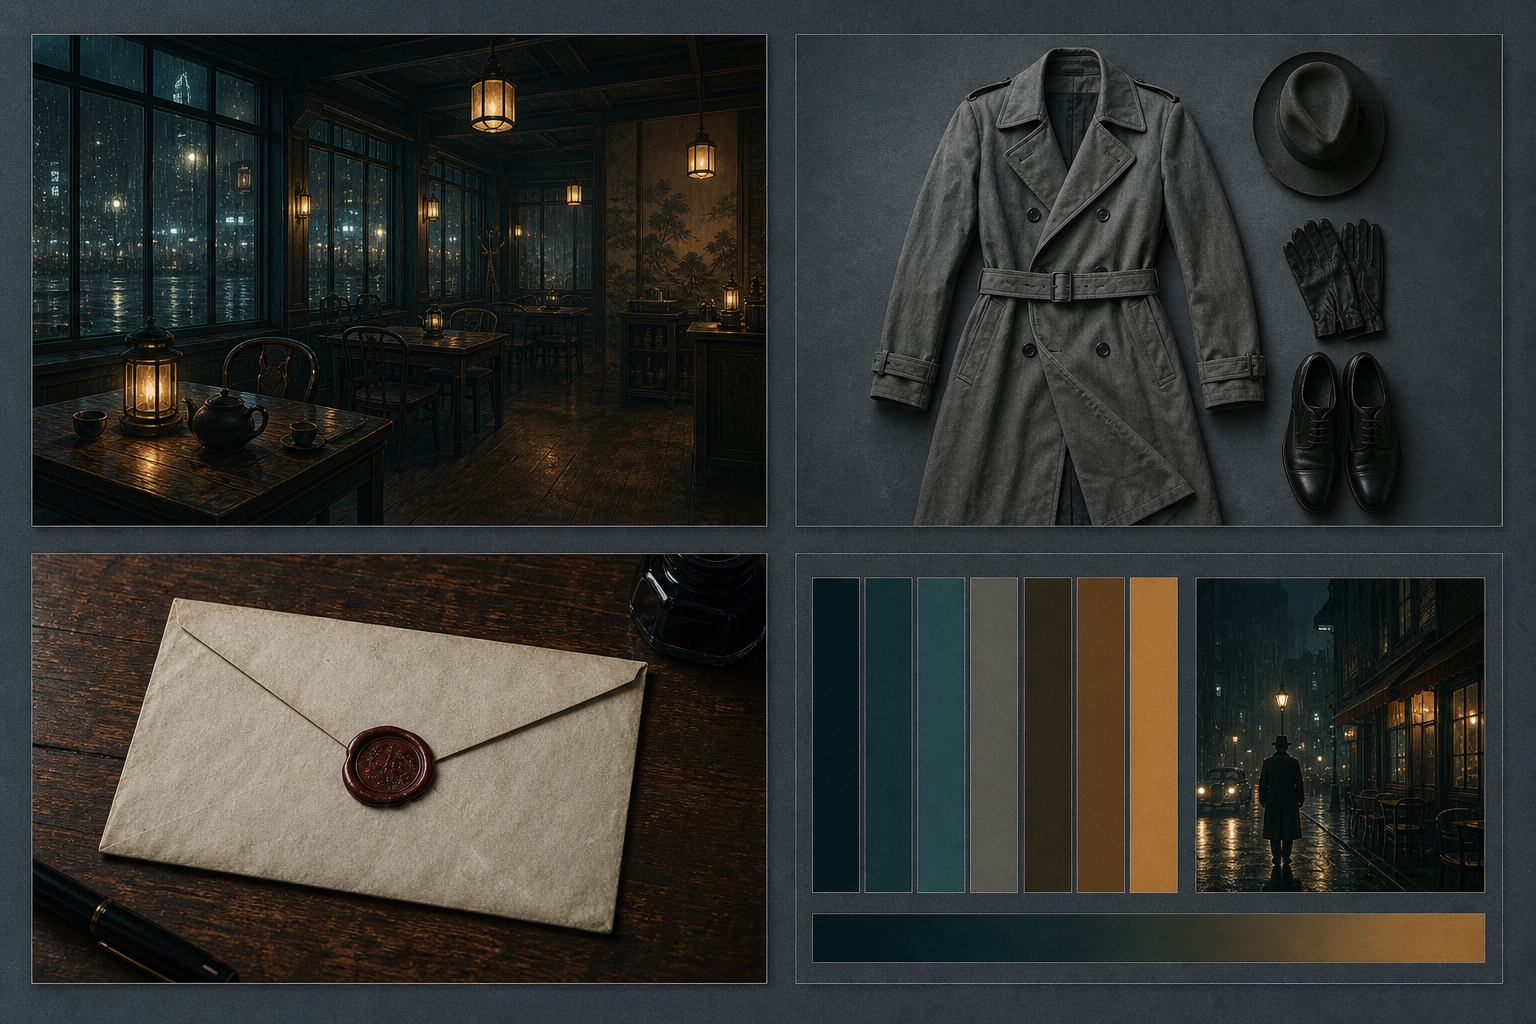
Positive
empty traditional Chinese teahouse interior at night, wooden tables, lattice windows with rain outside, warm practical lamps, cool teal shadows, no people, wide establishing shot, 24mm, deep focus, location scout photo, photoreal
Negative
crowded customers, readable shop signs, modern neon clutter, distorted perspective
空场优先,人物后合成;写入 loc.teahouse_night。
Positive
flat lay product photo of a tailored grey trench coat, visible buttons and belt, fabric weave detail, softbox lighting, plain neutral background, costume design reference, top-down, sharp, no model
Negative
worn by person, wrinkled mess, busy pattern overlay, logo text, hanger watermark
服装资产便于换装 I2I,与三视图外套描述保持同一色号措辞。
Positive
aged sealed paper envelope with dark red wax stamp on wooden table, soft side light, shallow depth of field, hero prop close-up, tactile paper fiber, no readable handwriting, cinematic still life
Negative
readable address text, modern courier bag, plastic shine, hands holding, logo
关键道具多角度各一张,供 inpaint 与特写镜头复用。
Positive
cinematic color style board, muted teal and amber noir palette, anamorphic still frames collage, subtle film grain, low contrast shadows, cohesive grade, mood reference sheet, no typography
Negative
neon cyberpunk overload, rainbow grading, text titles, cluttered collage labels
风格板作 Reference / Style LoRA 条件,全片调性锚点。
| 资产 | 提示词必含 | 入库字段示例 | 下游用法 |
|---|---|---|---|
| 三视图 | turnaround、同装同脸、A-pose、净背景 | char.lin.turnaround.v1 | LoRA / 全身一致性 |
| 脸部特写 | face close-up、中性表情、85mm、净背景 | char.lin.face.v1 | Face ID / IP-Adapter |
| 场景板 | empty、光位、焦距、无人物 | loc.teahouse_night | 关键帧背景 / Depth |
| 服装 | flat lay、材质、色号 | cos.trench_grey | 换装 I2I |
| 道具 | hero prop、材质、无可读字 | prop.letter_wax | 特写 / inpaint |
| 风格板 | palette、grain、时代感 | style.noir_teal | 全片 Reference |
编排台上「资产管理」节点应在批量镜头生成之前完成三视图+脸部特写人审。 定妆期用 IP-Adapter 快速锁脸;定妆通过后可训 角色 LoRA 量产。 详见 资产管理;镜头提示词只引用别名/触发词,不再每次重写五官。
有 Pose/Depth/Canny 时,提示词不要再详细描写站位与构图,否则两套指令冲突。文字专注服装、材质、光、风格;结构交给条件图与权重。
| 条件 | 提示词该写 | 提示词别写 | 权重直觉 |
|---|---|---|---|
| OpenPose | 服装、年龄、光影、风格 | 举手/转身等姿态细节 | 0.7–1.0 锁表演 |
| Depth | 材质、天气、色调 | 前后景相对位置长篇描述 | 0.6–0.9 保空间 |
| Canny | 上色、材质、时间 | 重新发明轮廓形状 | 0.5–0.8 保线稿 |
| 多 Control | 短正向 + 强负向 | 超长堆砌 | 主条件高、辅条件低 |
Positive(配合 OpenPose 条件图)
two characters in over-the-shoulder dialogue, char.lin grey trench, char.zhao dark suit, night teahouse interior, warm practical lamps, cinematic color, sharp eyes, natural skin
站位由 Pose 图决定;文字只钉身份与光。Control weight ≈ 0.85。
TTS 要写「怎么说」而不是「说了什么的文学修辞」;配乐写情绪、乐器、节奏与时长;SFX 写具体事件与空间感。
对白文本
你还记得雨夜的码头吗?
风格 / 演技标签
speaker: char.lin_voice_v3 | tone: restrained, slightly probing | pace: slow | pitch: mid-low | breath: soft inhale before line | no smile
Prompt
sparse neo-noir underscore, low cello drone, distant muted trumpet motif, slow tempo 70 BPM, tense and intimate, no vocals, 25 seconds, fade out last 3 seconds
Negative
EDmrop, cheerful pop, loud drums, lyrics, choir
Prompt
steady night rain on tiled roof, soft indoor room tone, occasional distant thunder, stereo wide, loopable 10 seconds, no music
模型家族对「标签汤 / 自然语言 / 电影指令」偏好不同。工作流应在「提示词编译」节点按 model_family 切换模板,而不是人手改来改去。
| 模型家族 | 偏好句式 | 写法要点 | 慎用 |
|---|---|---|---|
| SD 1.5 / SDXL | 逗号分隔标签 + 权重 | (keyword:1.2)、质量标签有一定作用;负向很重要 |
超长散文、互相矛盾标签 |
| Flux / 新一代 T2I | 短自然语言段落 | 完整句子描述关系;少堆「8k, masterpiece」 | 过度权重语法、空洞质量词 |
| Kolors / 国产 SD 系 | 中英混合均可 | 中文主体描述清晰;专有名词可英文 | 中英重复同义堆砌 |
| 可灵 Kling | 电影分镜式中英 | 明确运镜、主体动作、时长感;I2V 强调保持 | 一次要求多种剧烈运动 |
| Runway Gen | 简洁英文电影指令 | 相机动词 + 场景;可配合运动笔刷 | 超长小说式段落 |
| Luma / Dream Machine | 自然描述 + 运动 | 因果清晰的短句;起幅落幅明确 | 抽象情绪词堆叠 |
| Sora 类通用视频 | 叙事性自然语言 | 时间顺序清楚;物理常识自洽 | 要求精确品牌字形 |
| ComfyUI 图(多模型) | 节点级拆分 prompt | 主模型 / Refiner / Control 各写各的短句 | 一个巨型字符串打天下 |
Spec:char.lin 窗边坐着,侧光,MCU,缓慢推近,6 秒。
char.lin, short black bob, grey trench coat, sitting by window, teahouse night, side lighting, rim light, medium close-up, 50mm, bokeh, cinematic still, film grain, looking aside
A woman matching char.lin with a short black bob and grey trench coat sits by a wooden teahouse window at night. Cool side light shapes her face. Medium close-up on a 50mm lens with soft background blur, quiet cinematic still.
镜头缓慢向前推,从中近景推到面部特写,她轻轻眨眼,口唇微动,肩部保持静止,身份与服装不变,时长6秒
| 失败模式 | 建议负向词(节选) | 适用 |
|---|---|---|
| 手部崩坏 | deformed hands, extra fingers, fused fingers | T2I 人物 |
| 脸部漂变 | duplicate face, asymmetric eyes, face morph | I2V / 多镜 |
| 文字污染 | watermark, logo, subtitle, readable text | 全域 |
| 视频闪烁 | flickering, sudden cut, teleport | T2V / V2V |
| 过度磨皮 | oversmoothed skin, plastic skin, doll-like | 写实人像 |
成片听感决定「是否像作品」。音频链路通常与画面并行:NLU 抽出对白与情绪后即可启动 TTS 与配乐,最后在合成节点对齐时间轴。
多角色音色、情绪、语速。资产库保存 speaker embedding,避免每镜换嗓。
按场景情绪与时长生成 BGM;注意版权与品牌安全策略。
脚步、门响、雨声等;可检索素材库或文生音效。
用人声驱动口型,修复 T2V 口型漂移;对话特写几乎必备。
模型选型应挂在工作流节点上,而不是悬空比较参数量。下表按节点给出代表性方向(生态变化快,以「能力匹配」为准,具体产品名会迭代)。
通用 LLM(结构化输出)、轻量 NER/分类器做槽位兜底;长剧本用分场 map-reduce。
按 model_family 切换模板(标签汤 / 自然语言 / 运镜指令);可用 LLM 从 Shot Spec 生成正负向与 motion_prompt,再人工闸门。
SDXL、Flux、Kolors、各类商业文生图;一致性靠 IP-Adapter、PuLID、角色 LoRA、Reference。
IP-Adapter / FaceID:参考图即用;角色 LoRA:同族底座训练后的 .safetensors + 触发词。可与 ControlNet 并行。
ControlNet / T2I-Adapter;预处理器:Canny、MiDaS/Depth Anything、DWPose/OpenPose。
可灵 Kling、Runway Gen 系列、Luma、海螺/可图视频、CogVideoX、SVD 类图生视频、Sora 类通用视频模型等。
支持 Start–End / First-Last Frame 的视频接口(可灵、Runway、可图等商业能力及部分开源管线);尾帧常由首帧 I2I 派生以保身份。
带 Control/光流约束的视频重绘管线;部分商业工具提供「风格迁移」「角色替换」预设。
TTS(多音色克隆)、MusicGen / Stable Audio 等文生乐、专业 SFX 库;唇形:Wav2Lip、SyncTalk 等。
ComfyUI 图、自研 DAG(Temporal/Airflow 类)、或视频 Agent 框架;关键是制品契约而非 UI。
身份敏感镜头优先「关键帧审核 + I2V/首尾帧 + 资产锁」;落幅明确必出尾帧;氛围空镜可用强 T2V;对话特写预留唇形节点预算。永远为单镜头失败准备降级路径。
资产管理(Asset Management)是跨镜头一致性的数据库。没有它,工作流只是「多次随机生成」;有了它,才能版本化、复用、溯源与合规。
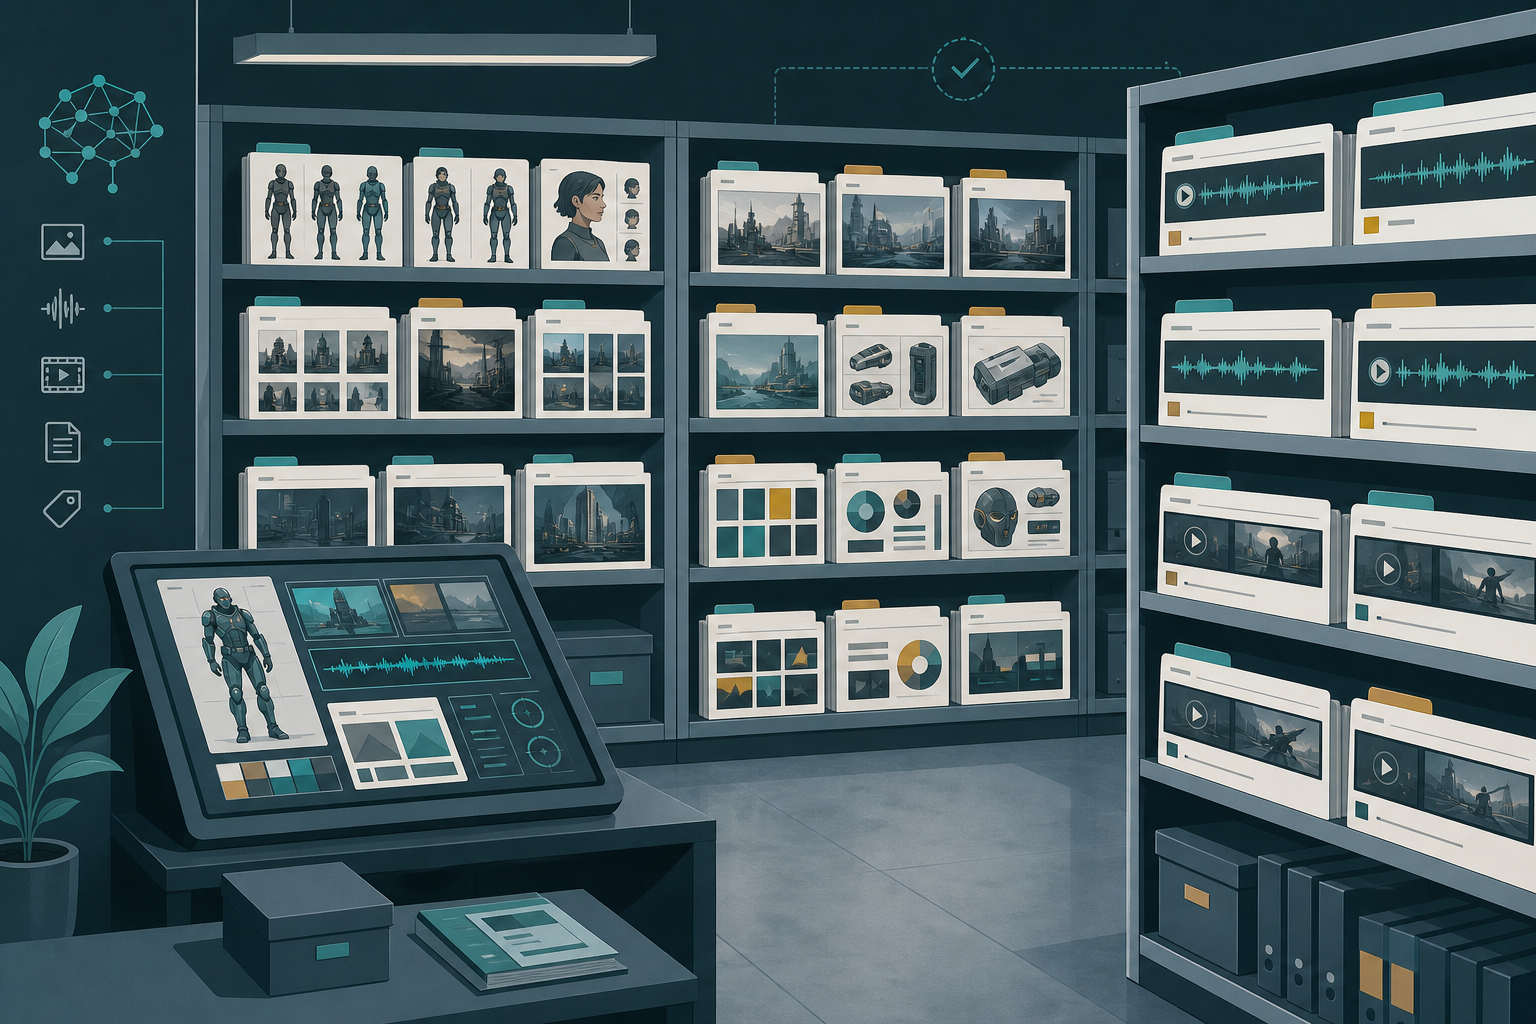
人物一致性最低配置是全身三视图与脸部特写。生成提示词与图例见 提示词 · 资产生成;此处强调入库形态。
char.lin.turnaround
char.lin.face
| 类型 | 内容 | 注入方式 |
|---|---|---|
| 角色 Character | 三视图、脸部特写、服装变体 | LoRA / IP-Adapter / 人脸 ID |
| 场景 Location | 场景板、HDR/光位参考 | 参考图、深度、风格提示 |
| 风格 Style | 调色、笔触、时代感 | Style LoRA、Reference、LUT |
| 道具 Prop | 关键物件多角度 | 主体参考、局部 inpaint |
| 音色 Voice | speaker embedding / 样本 | TTS 条件 |
| 音乐主题 | 主题旋律或情绪预设 | 配乐生成约束 |
| 镜头制品 | 历史生成的关键帧与成片段 | 缓存、V2V 源、复用 |
每个资产建议具备:asset_id、type、version、embedding_uri、license、prompt_alias、created_by、hash。
角色类资产另需:ip_adapter_ref(参考图 URI)、lora_path / trigger_word、recommended_weight。
工作流执行记录应写回:使用了哪些资产版本、哪个模型、IP-Adapter/LoRA 权重、Control 权重——这是复现与追责的基础。
IP-Adapter(Image Prompt Adapter)是挂在扩散主模型上的图像提示适配器:把参考图编成图像嵌入,经交叉注意力注入 U-Net/DiT,使生成结果贴近参考的主体、风格或构图语义——无需为每个角色单独训练权重文件即可「即插即用」。
参考图 → 编码 → IP-Adapter 注入 → 与文本条件共同驱动主模型
| 变体 / 近亲 | 侧重 | 推荐参考图 | 说明 |
|---|---|---|---|
| IP-Adapter(通用) | 主体 + 风格语义 | 定妆全身、风格板 | 最通用;权重过高会「抄构图」 |
| IP-Adapter-Face / FaceID | 人脸身份 | 脸部特写 | 对人脸更稳;常与 InsightFace 等配合 |
| IP-Adapter-Plus | 更细的图像特征 | 清晰参考、少遮挡 | 细节更贴,更易锁死姿态/构图 |
| PuLID / InstantID 等 | 强人脸 ID | 多角度脸图更佳 | 同属「图像条件锁脸」家族,接口类似 |
常见 0.4–0.85。低:像一点但仍听文本;高:更像参考,但场景/构图易被带走。
中性光、正脸清晰、无墨镜/手挡脸。与生成镜头光照差过大时,易「贴脸感」不自然。
char.lin.face.v1Pose/Depth 管结构,IP-Adapter 管身份——比单靠提示词堆外貌可靠得多。
优点:零训练、换角快、适合试妆与多角色并行。 边界:极端侧脸/遮挡、剧装大改、跨模型族复用时不稳定;长视频逐帧若每帧重编码,需注意时序漂移(可固定参考 + 关键帧 I2V)。
LoRA(Low-Rank Adaptation)是对主模型部分线性层做低秩增量微调得到的小权重文件。
角色 LoRA专门用该角色的多图数据集训练,使触发词(如 charlin / olin_character)在生成时稳定唤出该身份与标志性服装/气质——一致性通常强于单次 IP-Adapter,但需要训练与版本管理。
多图训练 → 角色 LoRA 文件 → 与主模型叠加推理
| 项目 | 建议 | 原因 |
|---|---|---|
| 数量与多样性 | 至少覆盖正/侧/3/4、远中近、不同光;优先用三视图+脸特写起步 | 避免只记住单一角度 |
| 清洗 | 去重、去模糊、去他人入镜、统一裁切策略 | 脏数据会「烙印」进 LoRA |
| Caption | 触发词 + 可变属性(服装/场景);固定身份少重复堆砌 | 让 LoRA 学「人」而非死锁某一件衣服(除非就要锁服装) |
| 底座模型 | 与上线推理主模型同族(如 SDXL LoRA 不直接套 Flux) | 跨架构几乎不可复用 |
| 过拟合征兆 | 换场景仍同一背景/姿势、皮肤塑料感、忽略 prompt | 减步数、增数据多样性、降 rank/学习率 |
加载
lora: char_lin_sdxl_v1.safetensors @ 0.8
Prompt
charlin, short black bob, grey trench coat, sitting by teahouse window at night, side light, medium close-up, 50mm, cinematic still
触发词 charlin 必须出现;服装细节可写短,因 LoRA 已学标志外观。权重 >1.0 易僵硬。
| 维度 | IP-Adapter | 角色 LoRA |
|---|---|---|
| 准备成本 | 一张(或少数)好参考图即可 | 需清洗数据集 + 训练 + 评测 |
| 上线速度 | 快,适合迭代试角 | 慢,适合定妆锁定后的量产 |
| 一致性强度 | 中~强(视变体与权重) | 通常更强、更稳 |
| 灵活换装 | 高(参考只锁脸时) | 取决于 caption 是否把衣服写死 |
| 多角色同镜 | 多参考 / 分区较直观 | 多 LoRA 叠加需控权重防互相抢 |
| 模型迁移 | 换主模型需对应 IP 权重 | 须按底座重训或找同族 LoRA |
| 工作流落点 | 资产节点存 ref 图 + scale | 资产节点存文件路径 + trigger + scale |
当前主流生成模型单次多输出 几秒到十余秒 的片段,不存在「一次 prompt 出 60 分钟」的可靠路径。 小时级成片的本质是:把长片拆成可调度的镜头工厂,用资产锁一致性,用编排做并行与返工,用剪辑轴拼成连续叙事。
类型:剧情短片加长版 / 网络剧单集体量 · 目标时长 约 60 分钟 · 主创 2 人 + AI 管线 · 主力角色 3 人(各备 三视图 + 脸特写,量产后上 角色 LoRA)· 主场景 4 处(茶馆 / 码头 / 巷弄 / 室内)· 对白驱动强,空镜与动作戏穿插。
长片层级:成片 → 幕 → 场 → 场景 → 镜头;永远以 Shot 为生成与返工单位
| 量级假设 | 数值 | 含义 |
|---|---|---|
| 成片时长 | 60 min = 3600 s | 含片头片尾与叠化 |
| 平均镜长 | 4 s | 对白偏短切、空镜可更长 |
| 镜头数 | ≈ 800–1000 | 本案例取 900 镜规划 |
| 关键帧 / 首尾帧 | 900–1800 张静帧 | 落幅明确镜用 FLF |
| 人审闸门 | 定妆 · 场次样片 · 粗剪 | 避免 900 镜全部盲生成 |
| 并行策略 | 按场次分队列 | 同场同资产,减少上下文切换 |
若自动化管线稳态为「每镜端到端 3–8 分钟」(含排队与偶发重跑),900 镜约需 45–120 GPU·小时量级,再加人工定妆、场次审片与成片包装。 实际瓶颈往往是一致性返工与对白/唇形,而非单次推理标称速度。
完整场次表、角色关系、视觉禁区(不可出现的元素)。输出可被 NLU 编译的结构化剧本,而不是散文。
三角色三视图/脸特写、四主场景板、关键道具、风格板;试镜通过后训角色 LoRA。未锁定禁止开大规模生成。
NLU/人工把每场拆成 Shot Spec:景别、运镜、时长、资产引用、start_frame/end_frame 需求。
先做 90–120 秒「高难场」(双人对话 + 推镜 + 雨夜)。验证 LoRA 权重、唇形、调色链路,再复制到全片。
按场次并行:静帧 →(Control)→ I2V/FLF;失败镜入重跑队列。上一镜尾帧可作为下一镜首帧保连续。
TTS/配乐/SFX 与画面时间轴对齐;唇形修复对话特写;粗剪→精剪→调色→字幕→母版。
| 环节 | 本案例选型思路 | Wiki 对应 |
|---|---|---|
| 身份 | 定妆 IP-Adapter → 量产角色 LoRA | IP-Adapter / LoRA |
| 结构 | 对话 Pose、运镜 Depth/Canny | ControlNet |
| 运动 | 默认可 I2V;落幅明确用首尾帧 | 首尾帧 / I2V |
| 对白 | 音色资产 + TTS + 唇形 | 音频 |
| 编排 | 以 Shot 为 DAG 节点,场次级并行 | 工作流 |
小时级项目的失败模式,大多是「短视频能忍、长片放大就崩」。下表按生产阶段列出高频问题与对策。
| 问题 | 典型症状 | 解决方案 |
|---|---|---|
| 跨镜换脸 / 服装跳变 | 同角色前后镜五官、发型、衣服色号漂移 | 冻结资产包;角色 LoRA + 脸特写 IP;提示词只引 prompt_alias/触发词;禁止场次中途换主模型族 |
| 单镜能成、接起来跳 | 剪在一起光位、站位、空间左右反转 | 分镜标注轴线;镜间用尾帧→首帧接力;同场统一场景板与色温;粗剪阶段先「静帧连环画」过一遍 |
| 长镜头中段崩坏 | 一次要 15s+,后半身份/肢体解体 | 拆成 4–6s 多镜或首尾帧分段;动作剧烈处加 Pose 序列;宁可剪辑制造「一镜到底」观感 |
| 对白口型对不上 | 特写说话时嘴型乱、齿形闪烁 | 画面先微动/闭口版 → TTS 定轨 → 唇形模型后处理;避免让 T2V「顺便演完长对白」 |
| 雨夜/复杂物理翻车 | 雨水穿模、积水倒流、衣物布料乱闪 | 降运动强度;用短循环环境层后期叠雨;关键道具用实拍/干净资产 inpaint,而非全靠文生物理 |
| 产能爆炸、返工黑洞 | 900 镜无优先级,坏镜拖死整片 | 样片 go/no-go;场次优先级;坏镜自动入重跑队列并限次;缓存命中相同 Spec+资产哈希 |
| 风格与调色不统一 | 有的偏青有的偏暖,像多部短片拼接 | 开拍前锁风格板/LUT;生成侧弱化「每镜自带调色」;成片统一调色与颗粒 |
| 多角色同框抢戏 | 两人戏变成「两张脸互相污染」 | 分区生成或分镜拍(正反打)再剪;双 LoRA 降权重;Pose 明确站位;难镜改过肩减少正脸同框 |
| 可读文字/招牌污染 | 背景假字、水印、乱码字幕 | 负向词表 + 场景板阶段清场;后期字幕统一贴;禁止在 prompt 里要求「写清店名」 |
| 音频盖过人声 / 节奏散 | BGM 过满,场次气口不对 | 先对白轨与气口再铺乐;按场情绪生成短 BGM 而非一轨灌满 60 分钟;响度标准化 |
| 版权与肖像合规 | 训练/参考疑似公众人物或受保护 IP | 资产来源审查;自建角色;商用模型条款核对;交付包保留溯源元数据 |
| 成本与排期失控 | GPU 账单与人工审片同步失控 | 按场次预算上限;低优先级镜降分辨率预览;只对「成片采用镜」跑最终分辨率;明确砍场机制 |
身份一致性、镜间连续性、对白唇形。这三项不过,小时级成片不可发布。
调色统一、物理瑕疵、多角色同框。可用剪辑与镜头设计规避一部分。
产能、成本、合规。决定能否按期交付与能否上架。
小时级 AI 长视频 = 短镜工业化 × 资产一致性 × 人审闸门 × 传统剪辑。 不要追求「模型直接吐长片」,而要追求「900 个可替换零件组装成一部片子」。 全书概念在编排台上的串联见 工作流编排。